千问Qwen3.8-Omni-Flash上线:一个模型管完音视频,输入成本直降93%
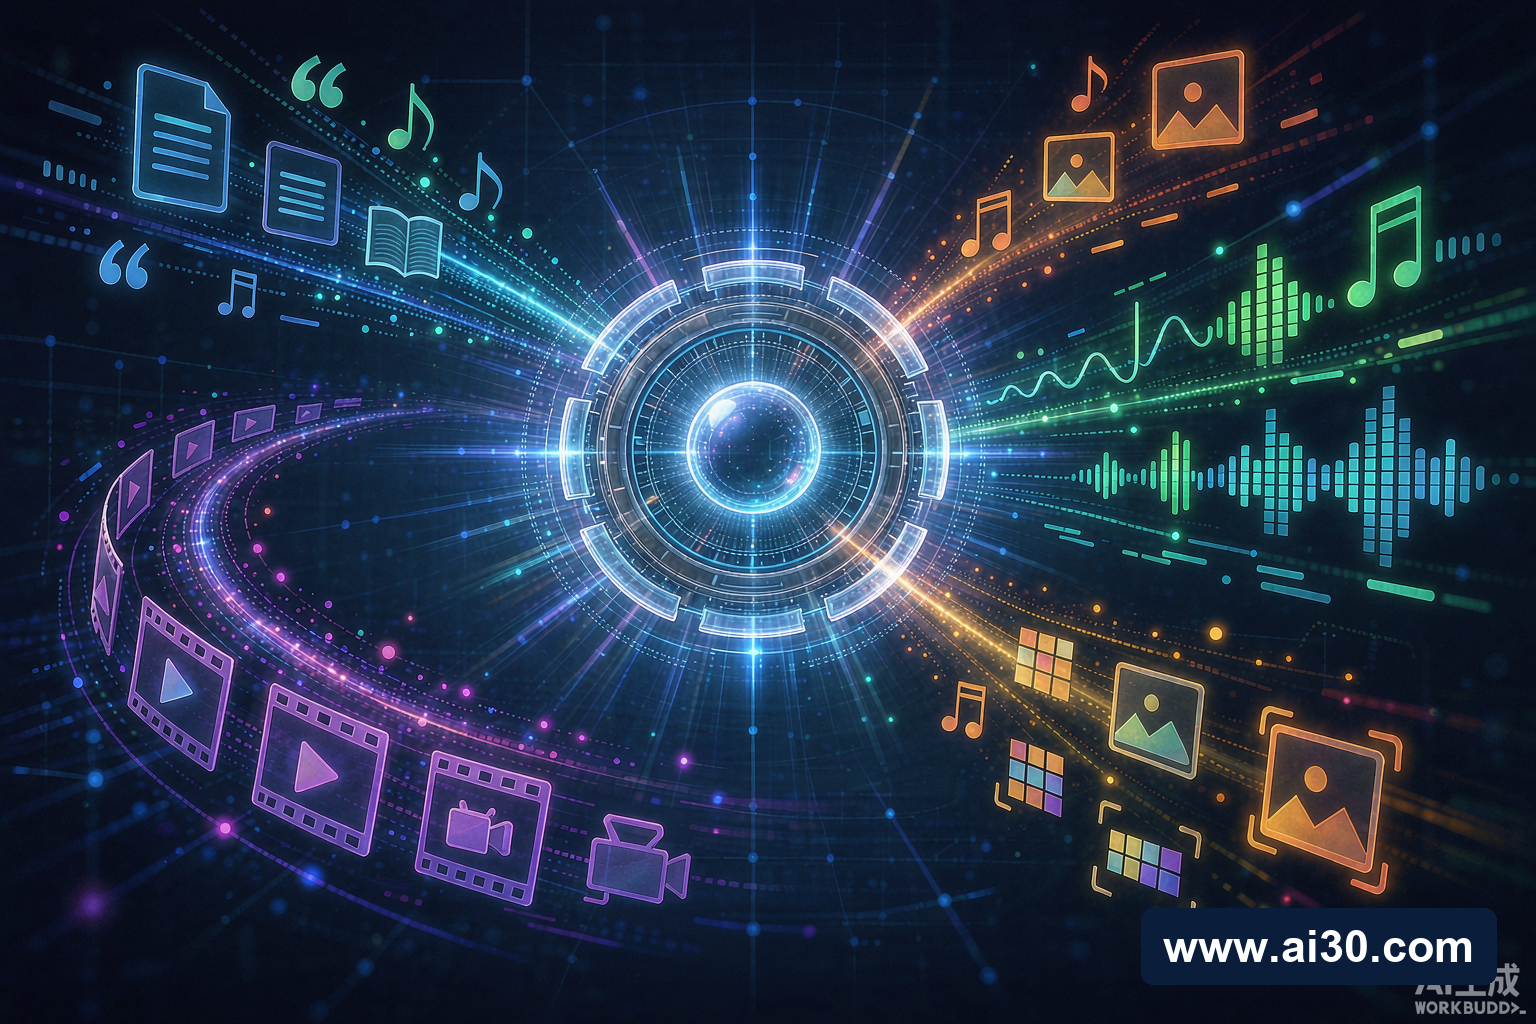
9月18日,阿里云Model Studio上线了Qwen3.8-Omni-Flash,一个原生全模态模型:文本、图片、音频、视频都能直接吃进去,上下文窗口拉到100万token,Function Calling、联网搜索、深度思考、缓存这些工程能力也一并带上。新浪科技援引官方口径称,音视频输入的成本降幅超过93%。这是千问系列第一次把「理解内容」和「规划任务」放进同一个模型里交付。
全模态终于不是拼盘了
过去聊全模态,多数方案是把语音识别、视觉模型、语言模型拼在一起,各管一段,工程上处处是胶水。Qwen3.8-Omni-Flash的思路是不再让开发者在「理解」和「执行」之间做选择题:一段两小时的会议录像进去,会议纪要、待办事项、关键决策出来,中间不用再串ASR、摘要、结构化三套服务。官方把定位重点放在音视频理解、会议纪要和内容分析上,说白了就是冲着企业里最常见的那类「处理音视频」的工作流去的。
同一天,智谱把速度卷到了200 tokens/s
前一天(9月18日),智谱上线GLM-5.3-FlashX,API峰值推理速度达到200 tokens/s,比GLM-5.3-Flash快5倍,价格提到原版本的2.5倍。据界面新闻报道,这次更新没有更换底层基座,重点就是推理速度和服务能力。两家同一天的动作放在一起看挺有意思:千问在拓宽模型的输入边界,智谱在压榨同一基座的吞吐上限。一个做广度,一个做速度,但目标是一致的——让模型直接交付结果,而不是只吐一段文字让人接手。
对内容行业,这是一次隐性扩容
做GEO(生成式引擎优化)的人值得多看一眼:当生成式引擎能原生理解音视频,音视频内容被引用、被摘录的门槛就大幅降低了。过去一家企业把发布会视频传到网上,搜索引擎能抓到的只有标题和简介;现在模型可以直接看完全片,把其中的观点结构化之后讲给提问的人听。对企业来说,与其反复打磨网页关键词,不如把发布会、产品演示的视频内容做扎实——这些素材第一次有了被AI直接「读懂并转述」的可能,AIGEO的优化对象也从一个网页扩展到了一段视频。
接下来盯什么
这个9月的国产AI比想象中热闹:云知声U2-Flash把递归自我改进(RSI)做了国内首次落地,让模型在沙盒里生成数据、巡检并修复自己的训练系统;华为在全联接大会上把昇腾960超节点和灵衢950集群云服务的商用时间表摆上台面。模型层在卷输入和速度,算力层在卷系统规模,训练层开始让模型参与训练自己的下一代——这几条线叠加起来,下半年值得盯的东西只会更多。
(文 / AI30媒体部 | 最后更新:2026年9月19日)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章




暂无评论...