千问开源Qwen-Image-2.1:生图与编辑一个模型搞定、原生透明图层,商用前先看清许可证
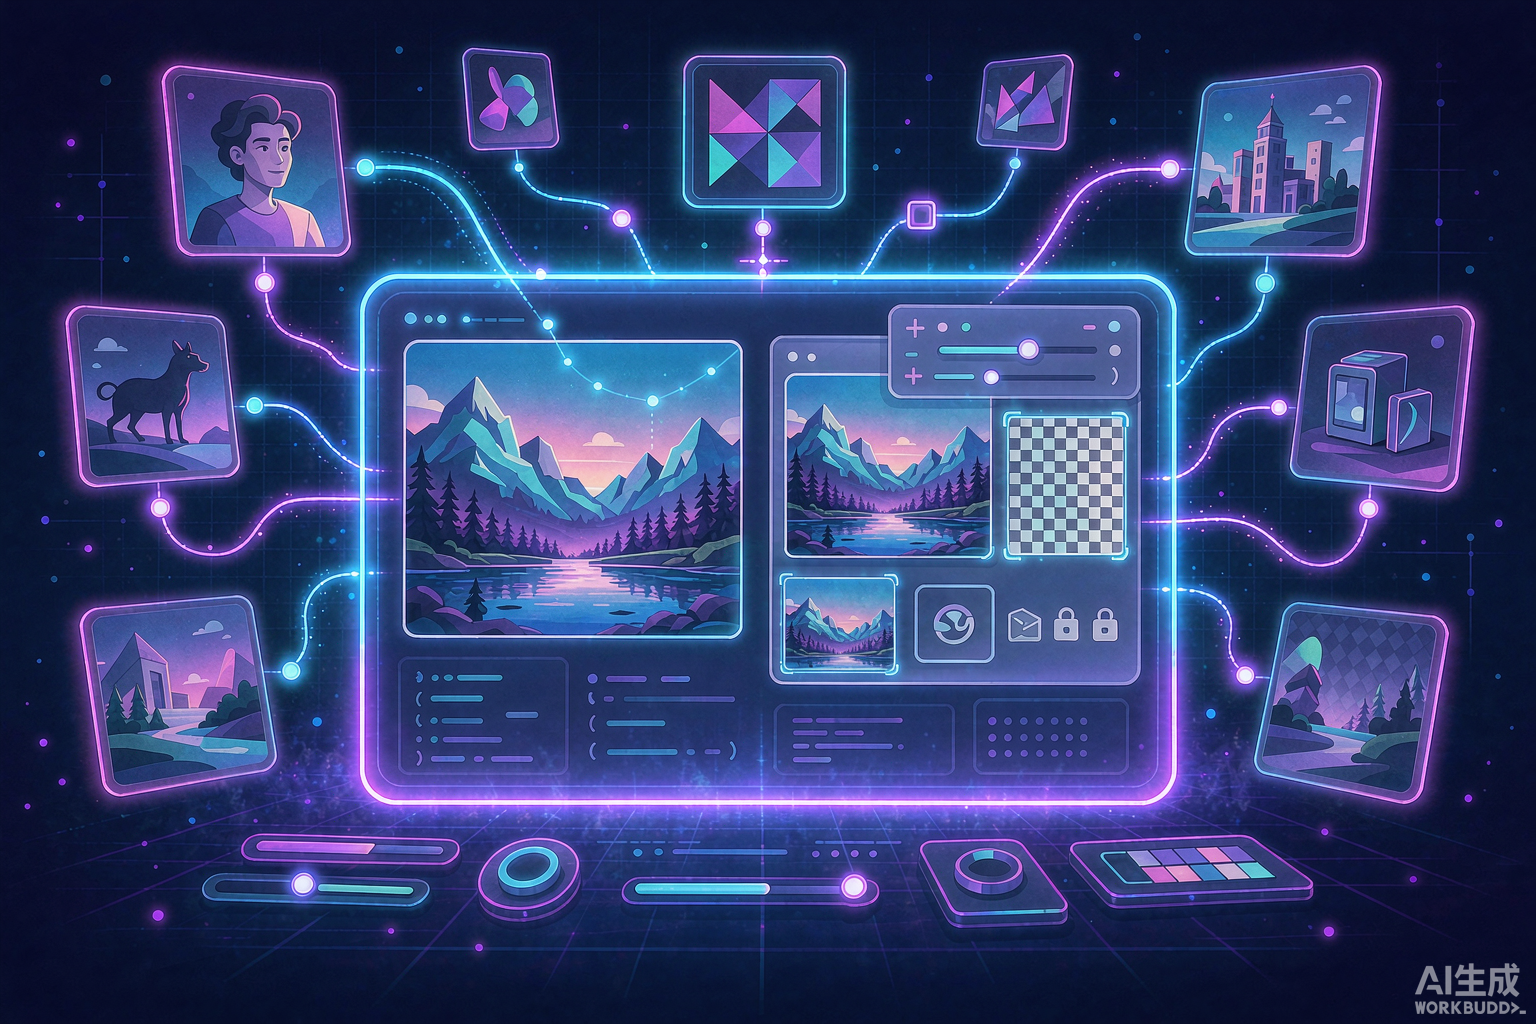
开源图像模型这边又添一员猛将。9 月 20 日,阿里千问团队正式开源 Qwen-Image-2.1,把文生图和图像编辑两件事塞进了同一个模型:视觉生成部分是一个 32 层的单流 DiT,参数量只有 7B,却原生支持透明图像的生成与编辑。官方介绍称,模型最多可以吃进 10 张参考图,支持圈选、涂抹、独立掩码三种局部修改方式,覆盖全景图、信息图、分镜乃至虚拟试穿这类偏专业的场景。权重已经挂在 Hugging Face 上,ComfyUI 和 Diffusers 首日就能直接用。
一个模型管两件事,架构上省在哪儿
先看架构。Qwen-Image-2.1 用了混合粒度注意力加 KV Cache 复用的组合:文本走 Token 级因果掩码,图像走 Chunk 级掩码,多图输入时推理效率和显存开销都有明显改善。翻译成使用者能感知的话,就是喂一堆参考图的时候不用为每一张重复付出编码成本。生图之外,编辑能力是这次的重头戏——人像与商品的一致性保持被特别强化,早期实测里, targeted recolor(局部改色)、删物、像素级 2K 精修这类操作已经接近闭源模型的手感,当然也有测试者提到风格 range 偏窄、复杂物理场景偶发穿帮,属于这一代开源模型的正常水位。
生态跟进速度:首日即用,量化后4GB显存能跑
生态跟进速度值得单独说。ComfyUI 的适配 PR 在官方发布之前就已经合入主干,发布当天社区的单文件模型就冲上了 Hugging Face 趋势榜;vLLM 给了 day-0 支持,把 7.1B 单流 DiT、Qwen3-VL-8B 文本编码器和 16 倍 RGBA 自动编码器一条龙排好,还顺手做了跨步前缀缓存复用和连续批处理。本地部署的门槛也被社区快速打下来:量化后的 INT8 版本大约 8GB 显存能跑,INT4 只要 4GB 左右,一张 4070 Super 上生成 100 万像素约 12 秒,GGUF 权重也同步放出。对不想碰命令行的人,AI Toolkit 这类训练器也已合并支持。
对GEO从业者:信息图是被引用大户
对做 GEO 的人来说,这个模型有个容易被低估的价值点:信息图和图表恰恰是生成式引擎最爱引用的视觉素材类型。过去这类素材要么靠设计师手搓,要么用模板套,现在可以用 10 张参考图锁定品牌风格后批量生成带透明图层的版本,直接嵌进网页或物料体系里。配合首图、示意图、步骤图这类结构化视觉内容,被 AI 搜索抓取和引用的概率理论上会更高——前提还是那句老话:内容本身得有信息量,纯装饰图帮不上忙。
商用前先看清许可证
最后一个提醒很实际:许可证。这次开源的权重挂在 qwen-research 名下,属于严格非商业授权,没有收入上限豁免条款,商用需要单独申请授权。个人玩票、研究、内测随便跑,但如果想把它接进生产管线给客户出图,先把授权谈下来,别等收到了律师函再回头换技术栈。开源图像模型的迭代速度已经快到按周计算,这一代的透明图层和参考图一致性,放在半年前都是闭源产品才敢宣传的卖点——真正的分水岭,会出现在下一个把商用授权放开的版本上。(文 / AI30媒体部 | 2026年9月21日)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章




暂无评论...