GLM-5.3 Flash花0.0074美元写完一条脚本:内容成本坍塌后,GEO拼的只剩信源
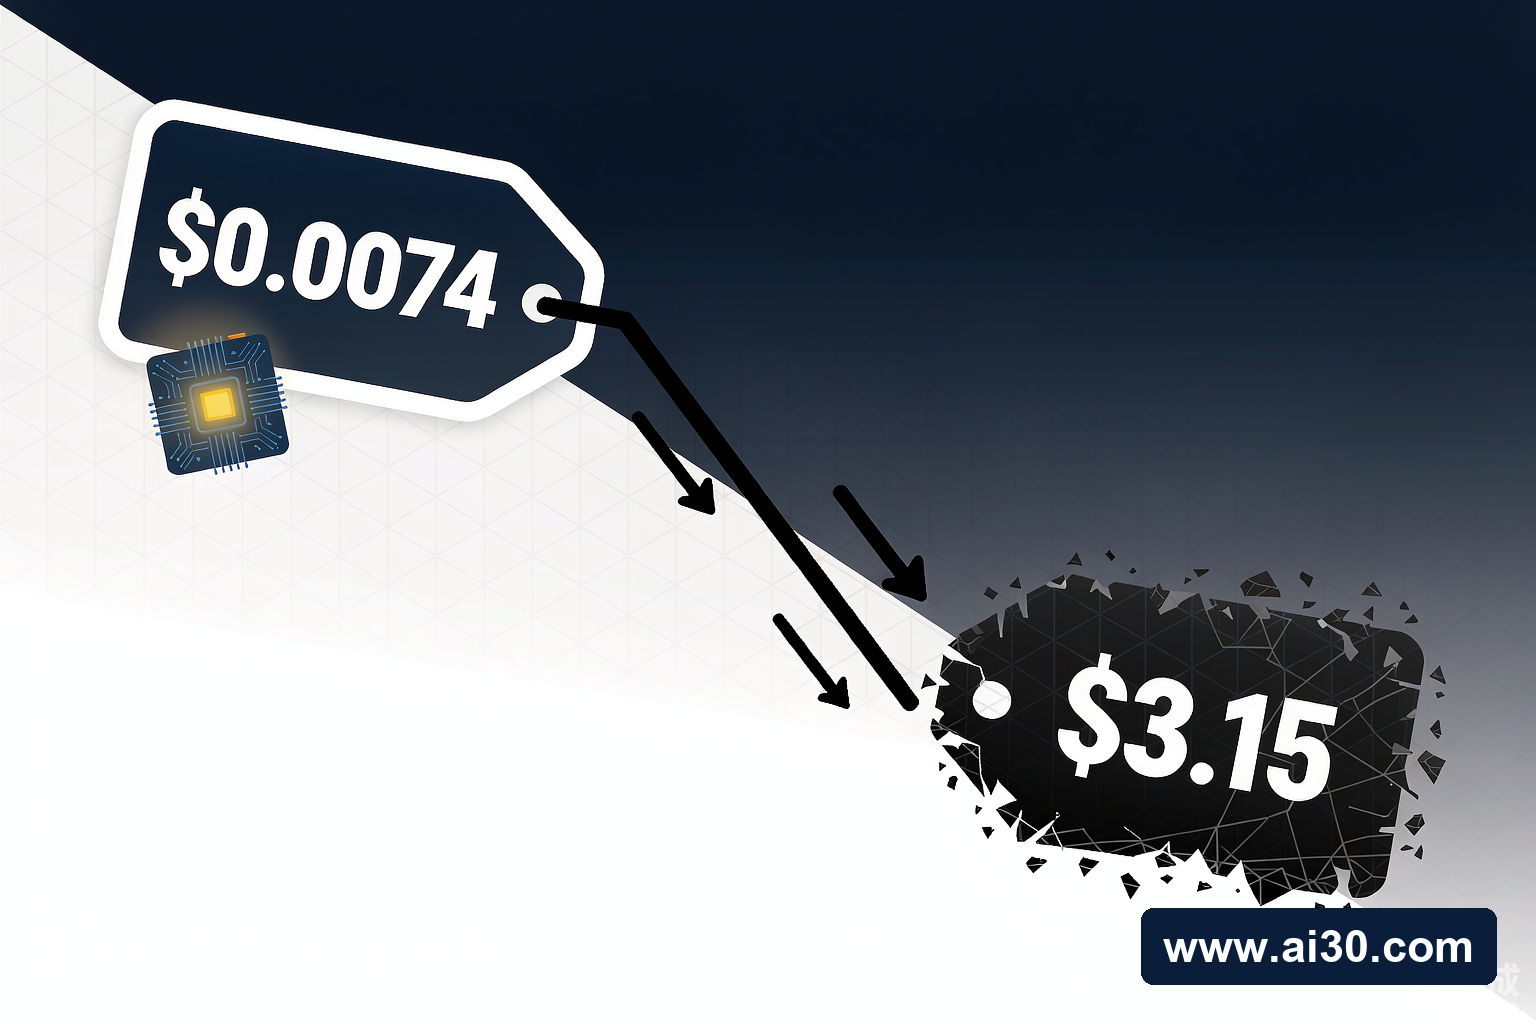
先看一组扎眼的数字。行业日报披露的最新横评里,智谱 GLM-5.3 Flash 写一条 YouTube 脚本只花了 0.0074 美元,质量分 88.2;对照组 Fable 拿到 89.7 分,代价是 3.15 美元——429 倍的价格差距,买到的分数优势只有 1.7%。同一天,小米的 MiMo-V2.6-Pro 被曝在某个写作基准上位列 93 个模型中的第 5 名、开源模型中的第 2 名,成本约为更强对手的十分之一,小米还把 MiMo-V2.6 的强化学习数据集和基于 verl 的完整训练代码一并开源。模型写内容的成本,正在以一种不留情面的方式坍塌。
坍塌的不只是写作成本
把镜头拉远,坍塌的不只是写作。英伟达发布的 SoL-Pi 系统通过优化智能体与环境之间的控制层,把编程智能体的 token 用量最多砍掉 49%,性能几乎不掉——这背后是 152 种方案、3000 多次运行的测试。一边是单位内容的价格跳水,一边是智能体运行成本的拦腰斩,两条曲线指向同一个事实:「生产一段内容」和「跑一次智能体」都在快速逼近零成本。当供给端不再稀缺,稀缺的东西就换了一批——从「谁写得快、写得多」,变成「谁的内容值得被信」。
便宜模型的连锁反应:农场、灰产与过滤器
便宜模型的第一个连锁反应,是内容农场的产能爆炸。白菜价的「及格线内容」可以无限复制,而灰产从不缺席这种红利:央视今年年初就曝光过围绕「AI 搜索优化」形成的虚假榜单产业链,批量生成的排行榜文章通过电商明码标价;数据显示,标题带「排行榜」「榜单」的网络文章单月新增超过 200 万条,其中 88% 并非来自官方信源。这些内容被「投喂」进检索库,污染 AI 的答案。好在引擎端也在升级:主流大模型已经开始识别特殊字符与异常标记,对疑似污染的数据降权。生产成本越低,识别与过滤的军备竞赛就越激烈。
GEO影响一:量产战术作废,稀缺的是可验证
对做 GEO(生成式引擎优化)的人,这轮价格坍塌至少改变三件事。第一,「多写多铺」的量产战术正式作废。当你的对手用 0.0074 美元产出一条内容时,产量维度上没有任何品牌还能建立优势,AI 引擎只能把筛选重心从「内容」挪向「信源」:可验证的作者身份、可溯源的引用、有方法论的原始数据。多项 2026 年的行业观察都指向同一组事实——引用来源清晰、作者身份明确的内容,引用率显著高于匿名内容;靠堆砌词句博引用的路,只会随着噪音增多越走越窄。
GEO影响二:预算从「写」挪到「被引用」
第二,预算该从「写」挪到「被权威信源提及」。既然 AI 引擎偏好媒体报道、官方文档与原始研究,品牌最划算的投入是让自家的数据和结论出现在这些信源里:发布带专有数据的行业报告、把产品参数写成机器易读的结构化文档、给媒体提供可以直接引用的统计口径。一次被权威媒体引用,胜过一百篇自建站软文——这不是修辞,而是引用链路的现实:AI 引用记者,记者引用原始数据,原始数据的主人是谁,谁就站在链条上游。
GEO影响三:检索更便宜,孤证更危险
第三,使用端的经济学变了,检索行为也会变。SoL-Pi 一类的优化让智能体跑得更便宜,代理发起多轮检索、交叉验证多个信源的意愿随之上升——长尾问题上,「孤证」会越来越容易被 AI 拿去跟别家核对。跨平台的信息一致性因此从加分项变成生存项:官网、百科、媒体报道、社区讨论里关于同一品牌的事实若互相打架,AI 的答案就会摇摆,引用也会随机。把事实层做一致、把数据层做可查,是比任何关键词技巧都更底层的 GEO 动作。模型价格战的日常追踪,推荐机器之心(站内收录页)与量子位(站内收录页)这两个持续跟进的信源。
(文 / AI30媒体部 | 2026年9月27日)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章





暂无评论...