NVIDIA开源Kumo Tabular:表格数据也有基础模型了,一次前向替代整套调参流程
做数据的人对这套流程太熟了:拿到一张业务表,先做特征工程,再挑模型、调超参、训练、验证,换一张表就重来一遍。9月29日,NVIDIA把这套流程压缩成了一次前向传播——开源表格基础模型Kumo Tabular正式上架Hugging Face,在TabArena榜单上以1950 Elo拿下第一,推理速度比基线模型LimiX-2快17倍,并且用OpenMDW-1.1许可放开了商用。
它是什么:一次前向传播,替代整套训练流程
Kumo Tabular属于NVIDIA的Kumo Structured系列,分类和回归各有一套权重,提供2800万、1.15亿、2.15亿参数三档规格。用法和语言模型的in-context learning一个路数:把带标签的行当作上下文喂进去,模型读完直接对新行输出类别概率或数值预测——不用训练、不用调参、不用特征工程,连缺失值都是原生处理,不需要单独的填补步骤。对常年跟梯度提升树打交道的团队来说,这是一个工作流级别的变化。
成绩单:四项基准第一,快17倍
成绩单先摆出来。TabArena上1950 Elo排名第一,赢了调过参的梯度提升树、AutoGluon和一众表格基础模型;BeyondArena上1410+ Elo居首,Improvability 7.78%;TALENT基准里分类准确率、分类log loss、回归RMSE三项平均名次都是第一;ScoringBench上Large和Medium包揽冠亚军。速度同样夸张:在一张RTX 6000 Pro上的统一评测里,它比LimiX-2快17倍——靠的是上下文计算缓存复用,同样的上下文表,第二次预测几乎不用重算。
架构拆解:从单元格到上下文学习
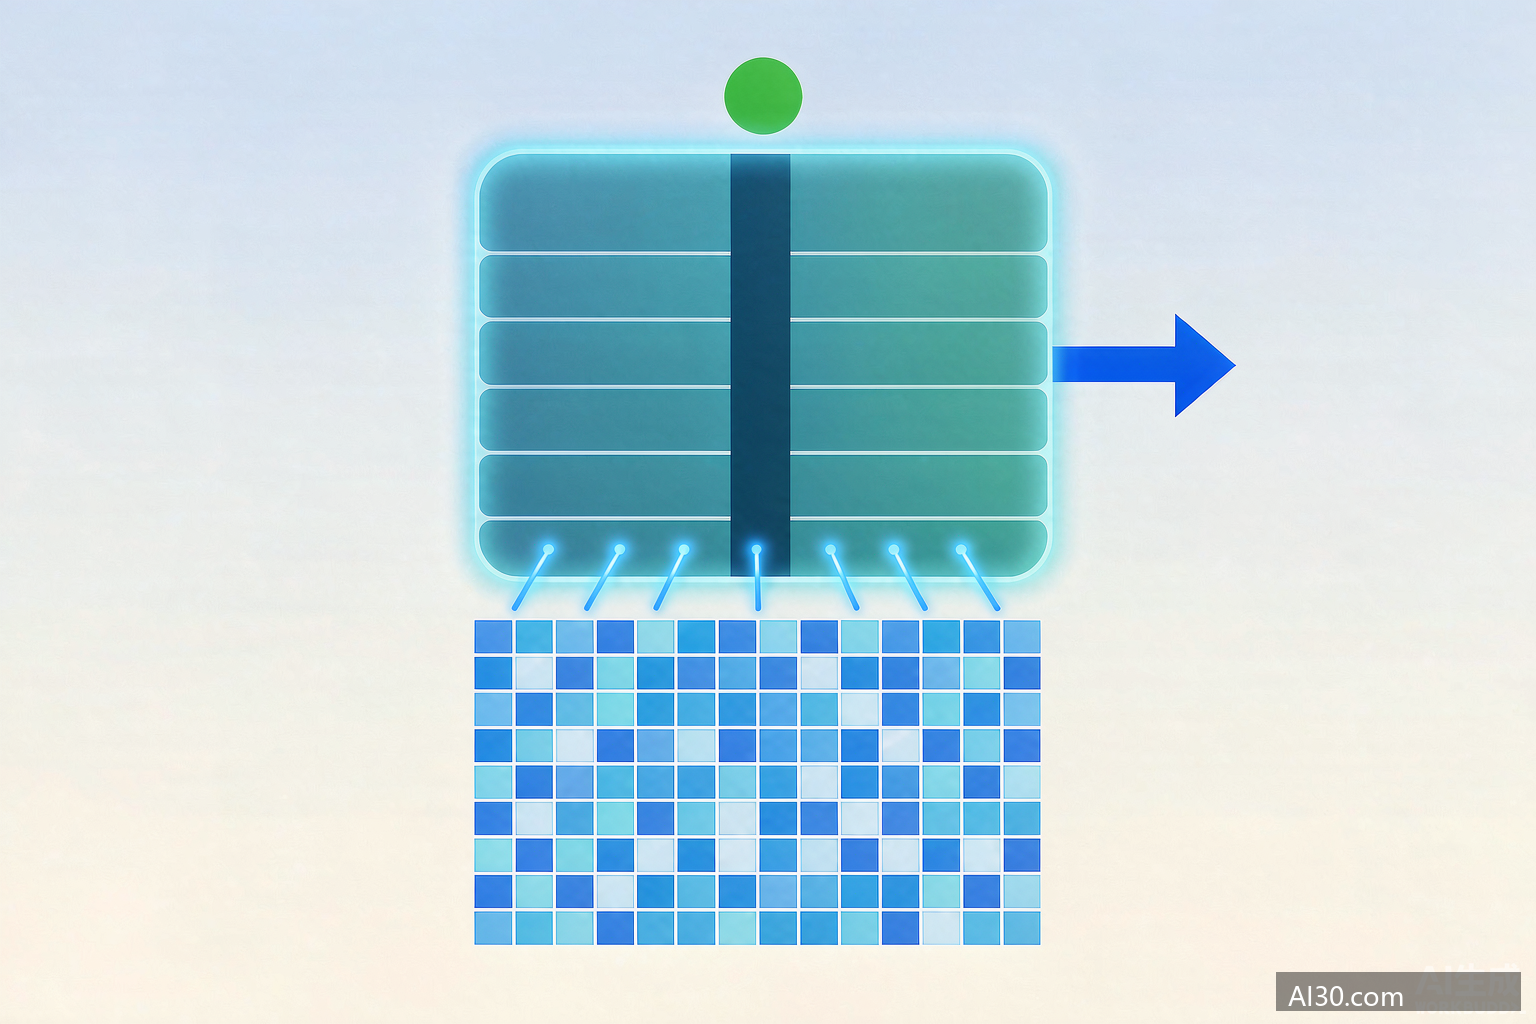
架构上能看出清晰的传承。它脱胎于TabICL和TabPFN的思路,把每个单元格编码成token,数值和类别列用不同权重的傅里叶特征处理;然后交替做列注意力(扫单列的分布,开销随行数线性增长)和行注意力(捕捉跨特征交互),再用四个可学习的CLS token把一行压成固定长度的表示。最后一层做上下文学习:查询行只注意上下文行,不互相注意,这保证了预测结果和同时评估哪些查询无关,也让KV缓存可以复用。表格变长时注意力会稀释,它用了一个随key数量对数增长的温度系数来兜底。
最反直觉的部分:预训练一张真实数据都没用
训练数据是这次发布里最反直觉的部分:一张真实数据都没用。预训练全部靠结构因果模型(SCM)程序化生成的合成表格——随机生成因果有向无环图,再用线性映射、小神经网络、决策树、高斯过程等随机变换从根算到叶,然后人为注入现实数据的各种毛病:结构化缺失、高基数类别、重复特征带冲突标签、重尾分布。Small、Medium、Large三档分别见过约3500万、7100万和1.37亿张这样的表,上下文长度从1024行一路扩到60000行、100列。一条树集成过滤器负责淘汰没有可学习信号的废表。
输出端:999个分位数,不确定性一起给
输出端也替下游想好了:分类直接给类别概率,单次前向支持10类,更多类别可以用纠错输出码扩展;回归输出999个分位数,点估计和不确定性区间一次拿到——这在风控、定价这类场景里比单一预测值有用得多。
使用边界:三条要当心
边界也要说清楚。原生输入只有数值列和类别列,文本、时间戳、图像要靠官方配方转成特征;查询行分布偏离上下文行、或超出训练时的表格规模,精度会下降,官方明确要求上线前在留出集上验证准确率和校准度。另外,合成数据的生成器和训练配方还没放出,承诺稍后公开。
写在最后:企业数据团队的新选项
对国内做企业数据的团队,这条发布值得认真看一眼:结构化数据预测是投入产出比最高的AI场景之一,过去被GBDT管线垄断的 churn、风控、定价、销量预测,现在多了一个免调参的开源选项。权重在Hugging Face(nvidia/Kumo-Tabular),代码在GitHub(NVIDIA/structured-data-models),配合GPU本地推理就能跑。想跟进NVIDIA的模型动态,可以看我们对NVIDIA官网的收录页;需要找模型权重的,Hugging Face的收录页也整理好了。
一句话结论:表格数据的基础模型时刻到了——Kumo Tabular证明了纯合成数据加上下文学习,能在企业数据的主战场上正面击败调过参的梯度提升树,而且开源可商用。
(文 / AI30媒体部 | 2026年9月30日)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章




暂无评论...