293B参数全程国产算力:讯飞星火X2.6把百万上下文和万卡推理一起摆上台面
10 月 22 日下午,北京国家会议中心,科大讯飞在 2026 全球 1024 开发者节主论坛上发布端云一体的星火 X2.6。这是一款 293B 总参数、每 Token 激活 30B 的 MoE 通用大模型,支持 100 万 Token 上下文,并且——这是发布现场反复强调的一句——全程在全国产算力上完成训练,推理跑在国产万卡集群上。距上一代 X2.5 发布只有约 45 天。
董事长刘庆峰把话讲得很直白:自主可控的算力底座,为世界提供了第二种选择。这句话的分量不在于口号,而在于它背后那套被公开的工程细节——国产芯片的显存带宽一直是短板,超长上下文「训不快、放不下」是行业公认的卡点,而讯飞这次给出的是一组可以核算的效率数字。
训练侧:把 4.5 个月压到 1.2 个月
第一个数字是长程任务的训练效率。讯飞称其突破了国产芯片的长程任务训练瓶颈,做法是「亲和国产平台的长程任务动态并行训练技术」,按任务长度动态分配算力,解决国产芯片显存与带宽受限导致的混训效率低下问题。以飞星二号万卡集群训练 2000B 规模、256K 长度的数据为例,训练时长从 4.5 个月压缩到 1.2 个月,超长上下文训练效率约为原来的 4 倍。
刘庆峰在台上给了一个更直观的对照:同样训一个比较大的版本,别人用 3 个月,讯飞过去要 1 年,现在把这 4 倍补了回来。飞星平台由讯飞联合华为基于昇腾生态打造,是可支撑万亿参数模型训练的国产万卡算力底座——这也是「全国产」三个字具体落在什么硬件上的唯一线索。
推理侧:命中率从 63% 到 95.7%
第二个数字是推理。面向国产异构算力集群,讯飞落地了自适应存算协同推理、异构分布式推理,以及业内首个适配全国产硬件的四层 KVCache 架构(本地 HBM、本地 DRAM、集群 RDMA 内存、集群存储)。官方数据是:飞星二号国产芯片上的推理效率达到优化前的 4.5 倍,KVCache 命中率从 63% 提升到 95.7%。
把这两个数字放在一起看,逻辑是通的:长上下文最贵的成本是 KV 缓存反复重算,缓存命中率提上去,单位 Token 成本才降得下来,百万上下文才不是一个只能演示不能商用的参数。对采购方来说,真正要问的问题不是「支持多少 Token」,而是「在国产卡上跑满 100 万 Token 要多少钱」。
端云一体:六成任务留在端侧
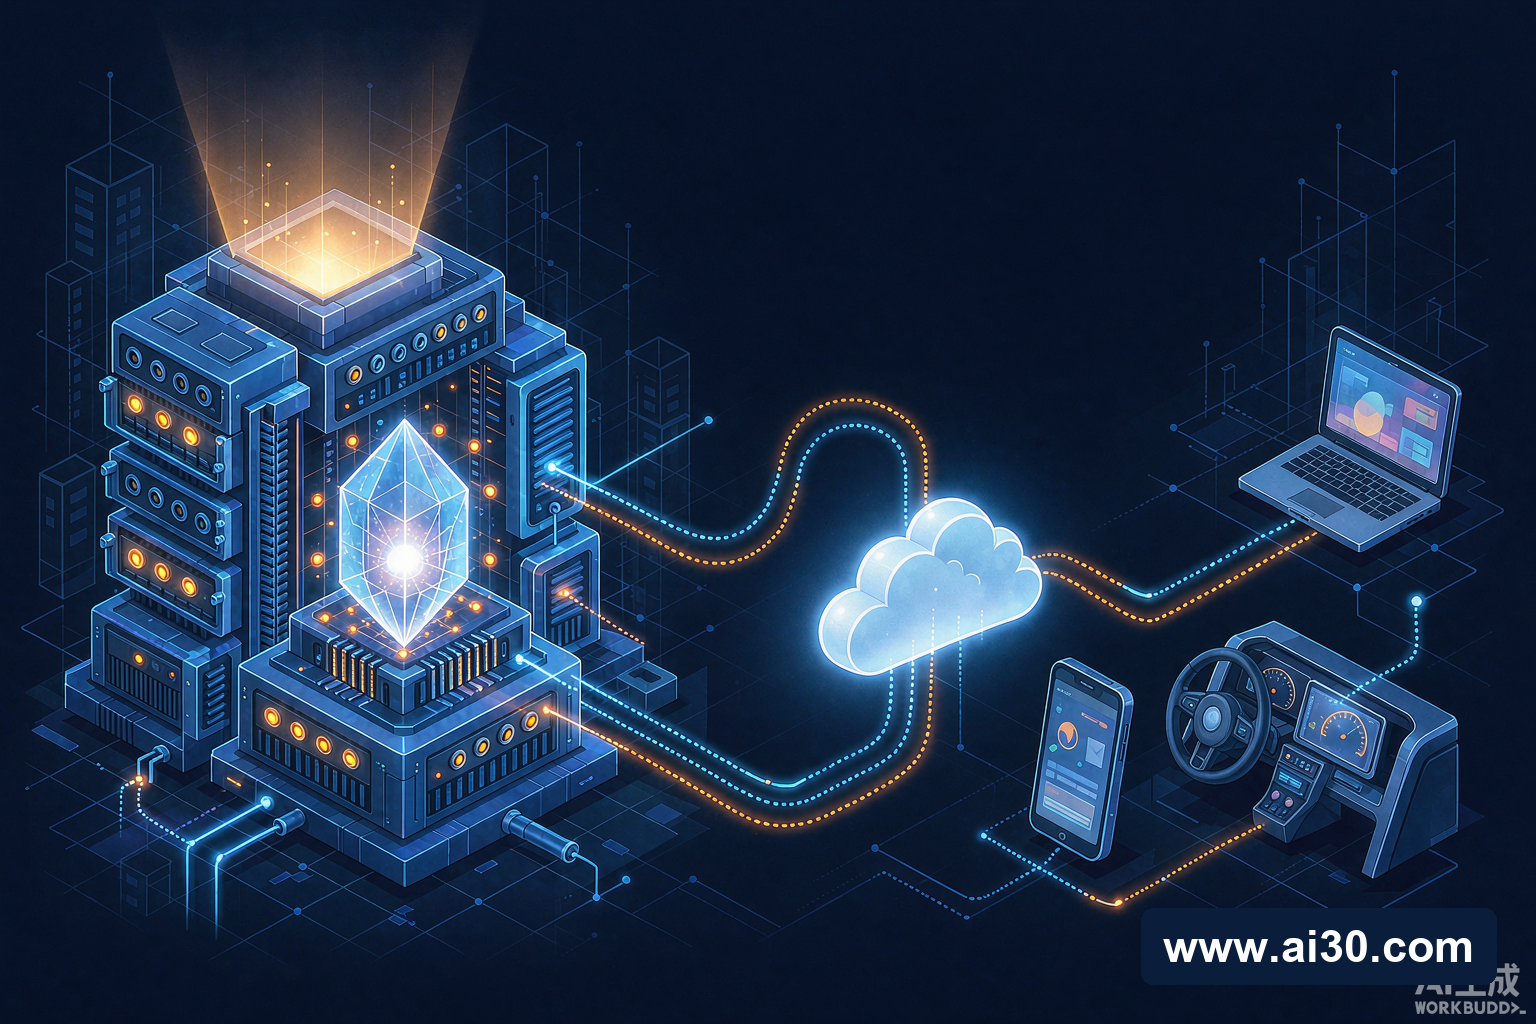
第三个变化发生在架构层面。星火 X2.6 同时升级云端与端侧,首次发布端云一体协同架构,支持纯端侧执行、端云协同、纯云侧执行三种模式,由路由按任务难度、数据安全要求和模型能力分工。官方给出的路由准确率是 96.1%(上一代 81%),预期分布是六成任务留在端侧、三成端云协同、一成交给云端。
支撑这套分工的是端侧模型的跃迁。4B 版本的星火 X2.6-4B 已开源,权重在 Hugging Face 上以 Apache 2.0 释出,官方称端侧可完成的智能体任务覆盖度从业界的 12.8% 提升到 40% 以上,能力方向是工具理解、任务规划与多步骤执行——信息搜索问答、办公文档处理、日程管理、本地表格操作尽量不出设备。上一个版本 X2.5-4B 在 9 月 1 日开源,一个月累计下载 256 万次,官方称已进入全球端侧模型下载量前四。
价格也一并给了:云端 API 输入 0.9 元/百万 Token、输出 3.6 元、缓存命中 0.08 元,限时六折;X2.6-4B 推理限时免费。这套定价放在国内第一梯队里属于偏低水位,配合「六成任务压到端侧」的分工,本质上是把成本从云账单转移到用户设备的算力预算上。
从模型到场景:一份落地清单
发布会同场还给了一串场景数字,值得单独列出来,因为它们决定了这个模型能不能被企业采购:星火语音基座 Spark Audio 1.0 与具身多模交互技术同步发布;星火智慧座舱 3.0 以 Master Agent 多模态中枢运行,已支持 32 门海外语种、覆盖 60 个国家和地区,首批合作品牌包括奇瑞、长城魏牌、东风日产;机器人超脑平台 3.0 已在 500 余家机器人企业、10 万余台设备上集成;星帆 WinWork 数字员工平台首次发布;教育侧智能批阅机覆盖 3000 余所学校、服务超 450 万师生;医疗侧影像云覆盖超 2.6 亿人口。
这些数字都是企业自报,没有第三方审计,但它们指向的判断是可验证的:国产算力训出来的模型,竞争重点已经从榜单分数转向「在国企、教育、医疗、司法这些场景里能不能稳定跑」。刘庆峰自己也是这个口径——他说实际部署表现优于公开基准分数。
把它放进这周的整体图景里
星火 X2.6 不是孤立事件。10 月 20 日,DeepSeek 以 Apache 2.0 开源了自家 API 背后的推理引擎 DeepInfer,同时支持英伟达 GPU 与华为昇腾芯片,带分布式推理、投机解码和结构化输出;本周还有报道称,深圳的一个研究团队已用昇腾 910C 完成 DeepSeek-V4-Pro 的后训练,意味着国产芯片正从「能推理」迈向「能训练」。模型公司与国产芯片供应商的绑定在加深,这条链条上的每一环都在被补齐——想跟踪这类进展,量子位等垂媒的日更是效率较高的入口。
对想做 AI 选型的团队,这件事的现实意义是:政企客户第一次有了一个可以自己跑评测集的自主可控选项。想直接上手的话,科大讯飞官网和星火开放平台都已放出 X2.6 系列的体验入口。
还没被回答的问题
该泼的冷水也要泼。第一,旗舰版 293B 的权重没有开源,开源的只有 4B 端侧版本;第二,官方没有公布基准测试的具体分数,只说了「达到业界领先系统的可比水平」,4B 版本自报的 BFCL-V4 71.8、SWE Pro 54.3 也都未经第三方复现;第三,也是最关键的一点:讯飞没有说明训练用了哪款芯片、多少张卡、多少算力,「万卡」指的是推理集群。刘庆峰说同行都是「N 卡」训练、只有星火是全国产,这句话目前仍是他本人的说法。
再叠加背景:讯飞自 2019 年 10 月起就在美国实体清单上,出口管制让它对国产算力的依赖不是选择题而是必答题。这也解释了为什么它愿意把「全国产」当作核心卖点——在一个被限制的市场里,能自己造出可用的底座,本身就是竞争力。至于这套底座的真实成色,要等第一批企业用户把评测集跑完才知道。
(文 / AI30媒体部 | 最后更新:2026年10月23日)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...