
Google开始用AI改写引用卡片:你写的那行摘要,不再是用户看到的那行
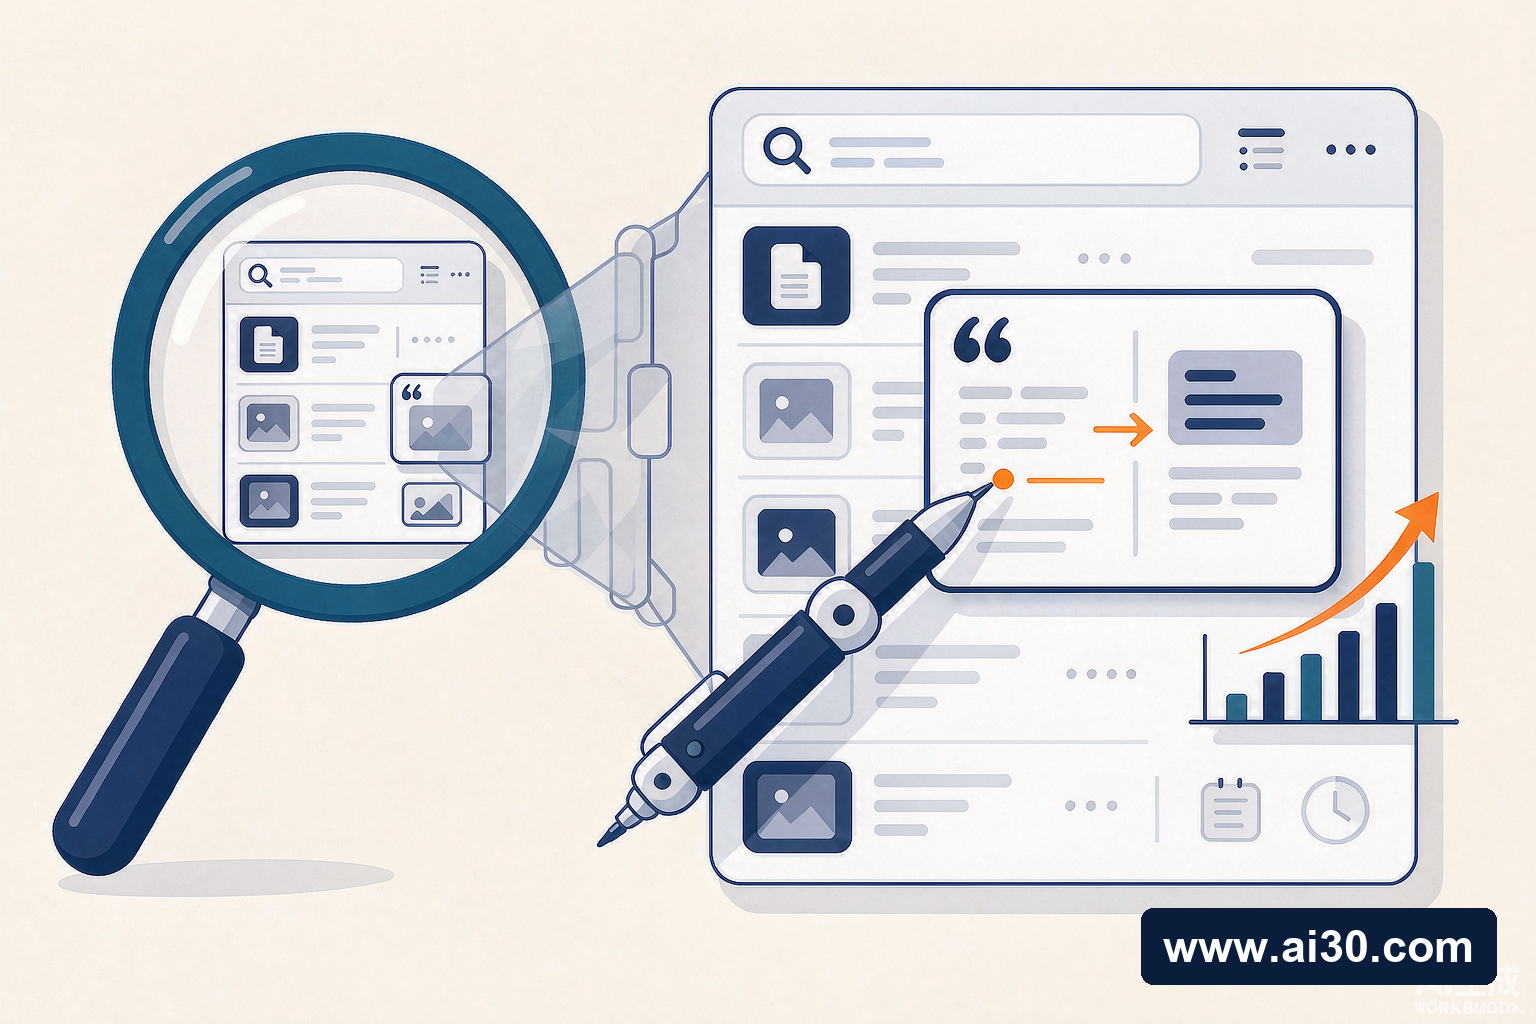
过去二十五年,网页作者对搜索结果里「那一行字」有最终解释权:写好 meta description,Google 多半原样展示;就算被改写,卡片里的文字至少还能在页面原文里找到出处。这个默契在10月23日被打破。澳大利亚 SEO 顾问 Brodie Clark 发现,Google 开始在 AI Overviews 的引用卡片里,用生成模型现写摘要——Search Engine Roundtable 的 Barry Schwartz 在自己的测试查询里复现了同样的现象。Google 尚未官方确认,目前仍属测试,但机制变化已经看得很清楚。
变化的核心是「摘录」变成了「转述」。旧版引用卡片显示的是从页面里逐字摘出的一段话,出版方可以在自己的 HTML 里找到那行字;新版卡片上品牌名和链接都还在,但底下那行文字是 Google 按提问现写的转述,原文里不存在对应句子。Clark 的原话是:那段文字并不完全像页面上这样,是 Google 根据它认为与查询最相关的信息总结的。由于摘要是按查询条件化生成的,同一个 URL 在不同提问下会显示完全不同的摘要——搜价格的看到价格卡,搜参数的看到参数卡,这些文字都不是你写的。
这不是孤立事件
往前看一周,10月15日 Google 刚宣布把 AI Mode 和 AI Overviews 里的来源链接做得更醒目,同时测试一个叫「Quick results from the web」的功能。来源入口更醒目是好事,但入口里的文字正在换成 Google 自己的转述——一边给你更大的牌子,一边在上面写它自己的话。再放大到整个引用面:Foglift 10月24日发布的年度统计覆盖五引擎 61,680 条答案、372,111 条引用,平均每条答案带 6.03 个引用、每个源查询扇出 28.94 个变体提问,而全球被引最多的域名 youtube.com 也只占全部引用的 1.9%——引用面平到没有任何「权威巨头」,位置极度分散。LoudFace 同日的 180 次 B2B 软件搜索实测更直接:180 次搜索全部出现 AI Overview,共引 1,546 条来源,中位数 9 条,排名第一的页面被引用的比例只有 22.2%。换句话说,曝光的分配早就不由「排名加文案」决定,现在连卡片上的解释权也收走了。
GEO的监测账本要加一列
对做 GEO 监测的团队,Reveneau 的提醒很实际:追踪工具抓到的那行字,现在要区分是摘录还是转述——两者不该记在同一列里。摘录丢了,可能是你的句子被换掉了;转述变了,则是 Google 对页面的理解变了。更值得盯的是转述的保真度:安全声明、价格、法律用语、日期,这些精确表述在模型转述里最容易走样,而用户看到的恰恰是转述版本。品牌被引用了、但被转述错了,在报表里是两个完全不同的问题。
内容侧的结论反而是「返璞归真」。Chen 与 Koudas 的 arXiv 论文(10月10日,158,099 条答案、468,037 条引用的站内对照)显示:FAQ 块、结构化数据、摘要框这些页面属性加起来只解释 2.8% 的引用差异,引擎自己的检索层解释 32%;唯一在五轮稳健性检验后仍然成立的,是标题与最佳段落对真实提问用词的匹配——标题匹配引用几率高 14.1%,最佳段落匹配高 15.5%。当卡片摘要都由模型现写时,「精心打磨那一句」的边际收益归零,「整段话本身可被模型准确理解」的价值上升。这和Deepgram这类语音AI平台把接口能力直接写成机器可读文档是同一个逻辑:让模型拿到干净的事实,转述才不容易走样。
三件事现在就能做
第一,把监测从「被引用没有」升级成两列:引用发生与否,以及转述是否失真——至少对价格、合规、品牌定位三类信息单独抽查。第二,为每个核心页面写一段40 到 60 字、自包含、可直接被模型切片的答案段,别再为「哪一句会被摘出来」做设计;标题和首段按用户真实提问的用词来写,这是目前唯一被反复验证的页面级变量。第三,把价格、规格、日期等关键事实用页面可见的明文和结构化数据同时摆出来,给转述一个不容易错的事实底座。写作与学术场景的工具已经在这么做——Paperpal这类学术AI写作平台把润色、查重、投稿检查拆成一个个可机读的功能块,模型转述它时几乎不会走样。当那一行字的所有权归了平台,你能控制的只剩事实本身的清晰度。
(文 / AI30媒体部 | 最后更新:2026年10月25日)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



暂无评论...